
De ChatGPT a un flujo n8n: tu primer agente sin código
Pasa tu hábito de ChatGPT (leads/emails) a un MVP n8n de 5 nodos con revisión humana: diagrama, system prompt, coste Starter y errores típicos.
Por DoAIWork Editorial · 28 de septiembre de 2026
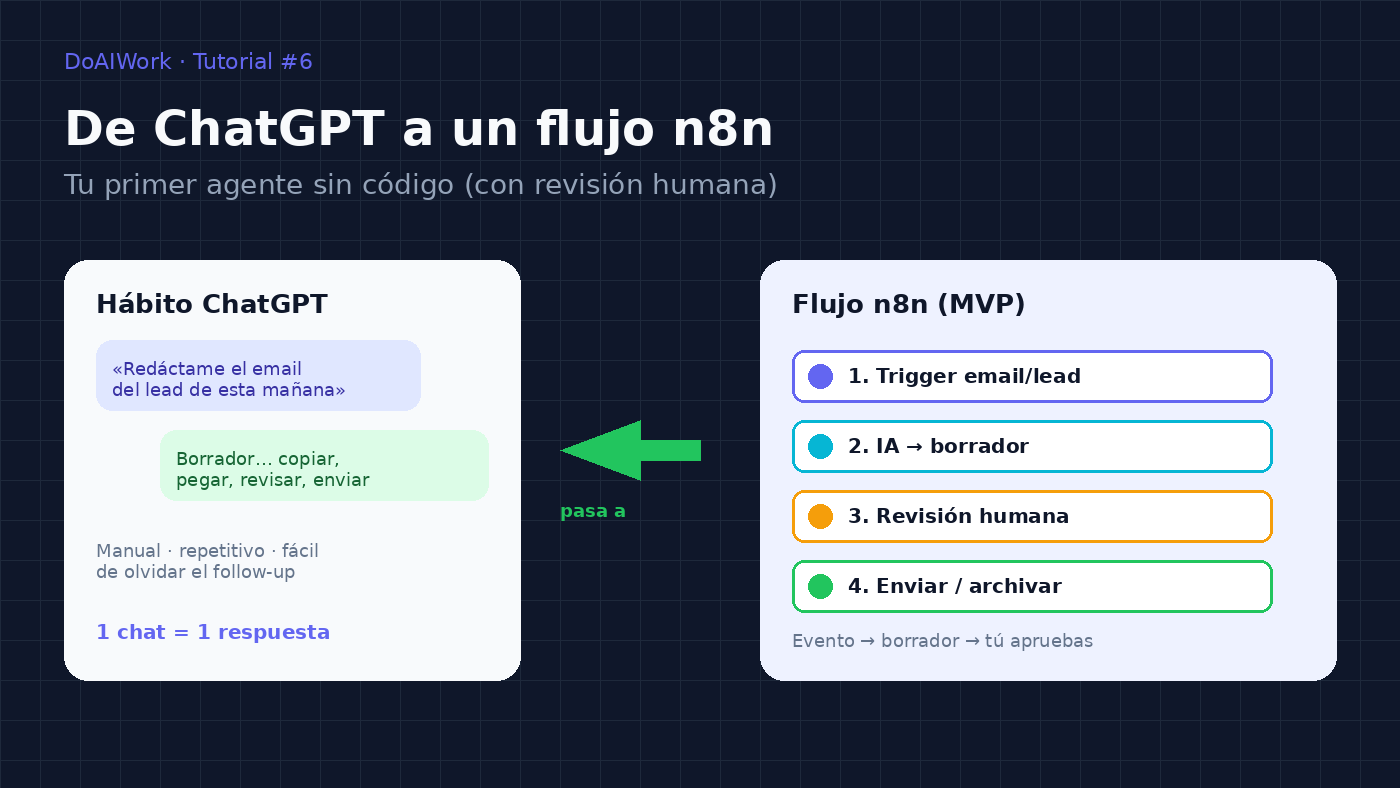
Usas ChatGPT casi cada día: llega un lead, abres el chat, pegas el mensaje, pides un borrador, copias, pegas en el email y envías. Funciona. También es frágil: si no estás delante, el hábito se para. Un agente en n8n no es magia 24/7: es el mismo hábito disparado por un evento (email nuevo, formulario, fila en una hoja) que genera un borrador y te lo deja listo para revisar.
Este tutorial monta un MVP de 5 nodos sin código: lead/email → borrador con IA → revisión humana obligatoria → enviar o archivar. No es un «agente que factura solo». Es automatizar el 80 % del trabajo repetitivo y dejar el 20 % (precio, tono, cierre) en tus manos.
Si aún no has decidido Make vs n8n, pasa antes por Make vs n8n (post #2). Si el modelo te genera dudas, Claude vs ChatGPT vs Gemini (post #3). Aquí asumimos n8n Cloud y un hábito de leads/emails que ya dominas a mano.
Qué vas a montar (MVP)
Caso: llega un email o un lead de formulario. El flujo:
- Detecta el evento.
- Normaliza nombre, email y un resumen corto (sin DNI, NIF ni IBAN).
- Llama a un modelo (Basic LLM Chain o AI Agent) con un system prompt cerrado.
- Te manda el borrador a Slack o a tu email: «aprueba / edita / descarta».
- Solo si apruebas, envía la respuesta o guarda la fila en Sheets.
Fuera de alcance hoy: WhatsApp Cloud API, multiagente, facturación automática, CRM completo. WhatsApp es el siguiente escalón → IA en WhatsApp Business (post #4), cuando el canal de verdad te lo pida.
Diagrama de 5 nodos (paso a paso)
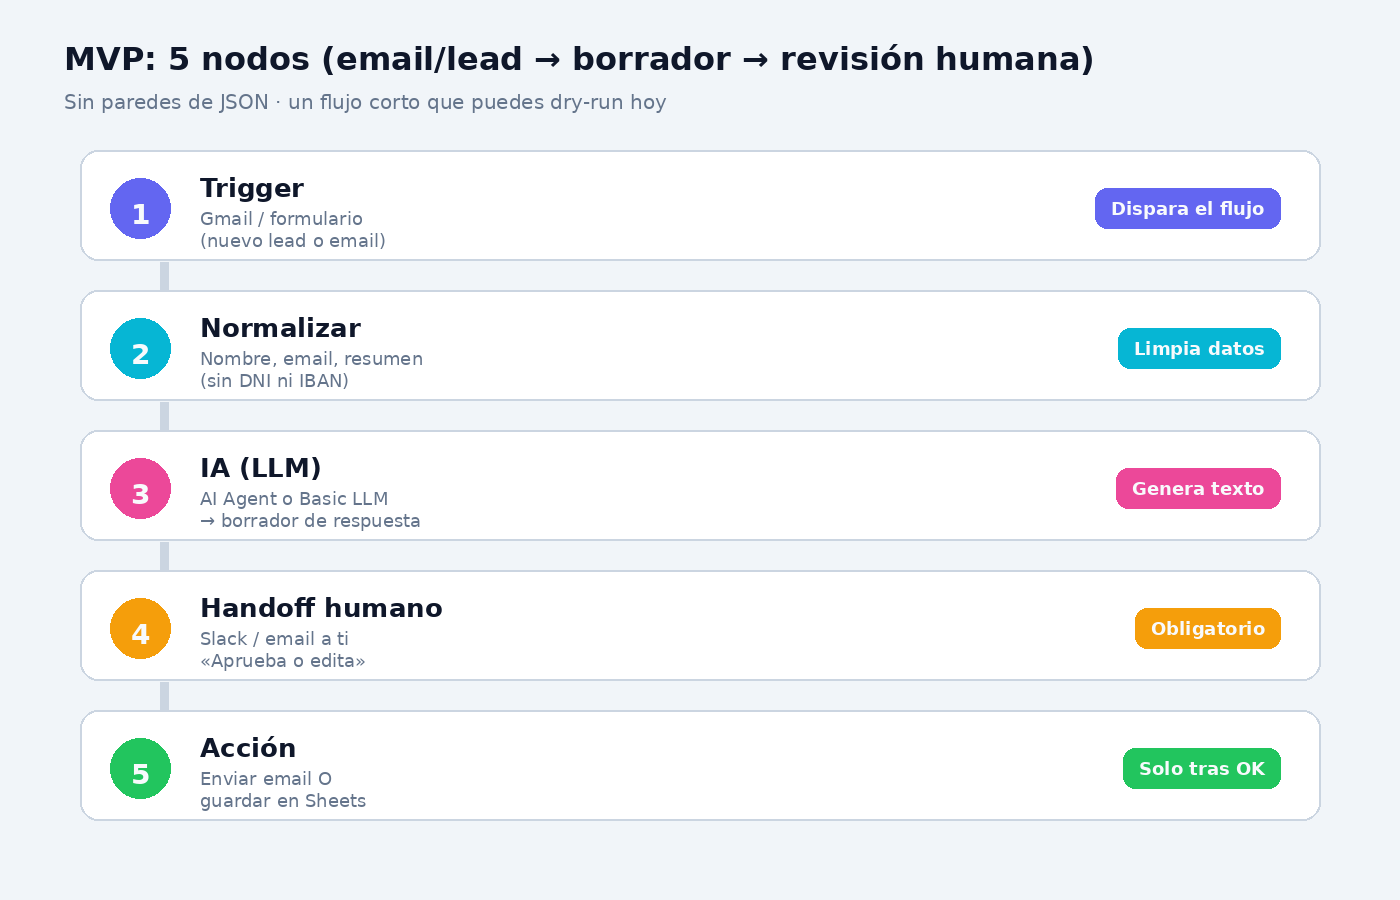
Nodo 1 — Trigger
- Gmail / Outlook: «email nuevo» con etiqueta
Leadso filtro de asunto (Presupuesto,Info,Contacto). - Formulario: webhook (Typeform, web propia) o «nueva fila» en Google Sheets si el form ya vuelca ahí.
Empieza con una fuente. Mezclar newsletter + facturas + leads en el mismo trigger es el error nº 1.
Nodo 2 — Normalizar
Extrae solo: fecha, nombre o remitente, email/teléfono, asunto, resumen ≤80 palabras. Anonimiza lo sensible antes de mandarlo al modelo. Guarda el original en la hoja; al LLM solo el resumen limpio.
Nodo 3 — IA (borrador)
Dos opciones en n8n (docs Agent):
| Basic LLM Chain | AI Agent | |
|---|---|---|
| Qué hace | Prompt → texto | Puede usar tools y razonar en pasos |
| Para este MVP | Ideal | Solo si necesitas tools (Sheets, búsqueda) |
| Riesgo | Bajo | Más tokens e impredecibilidad |
| Handoff humano | Igual de obligatorio | Igual de obligatorio |
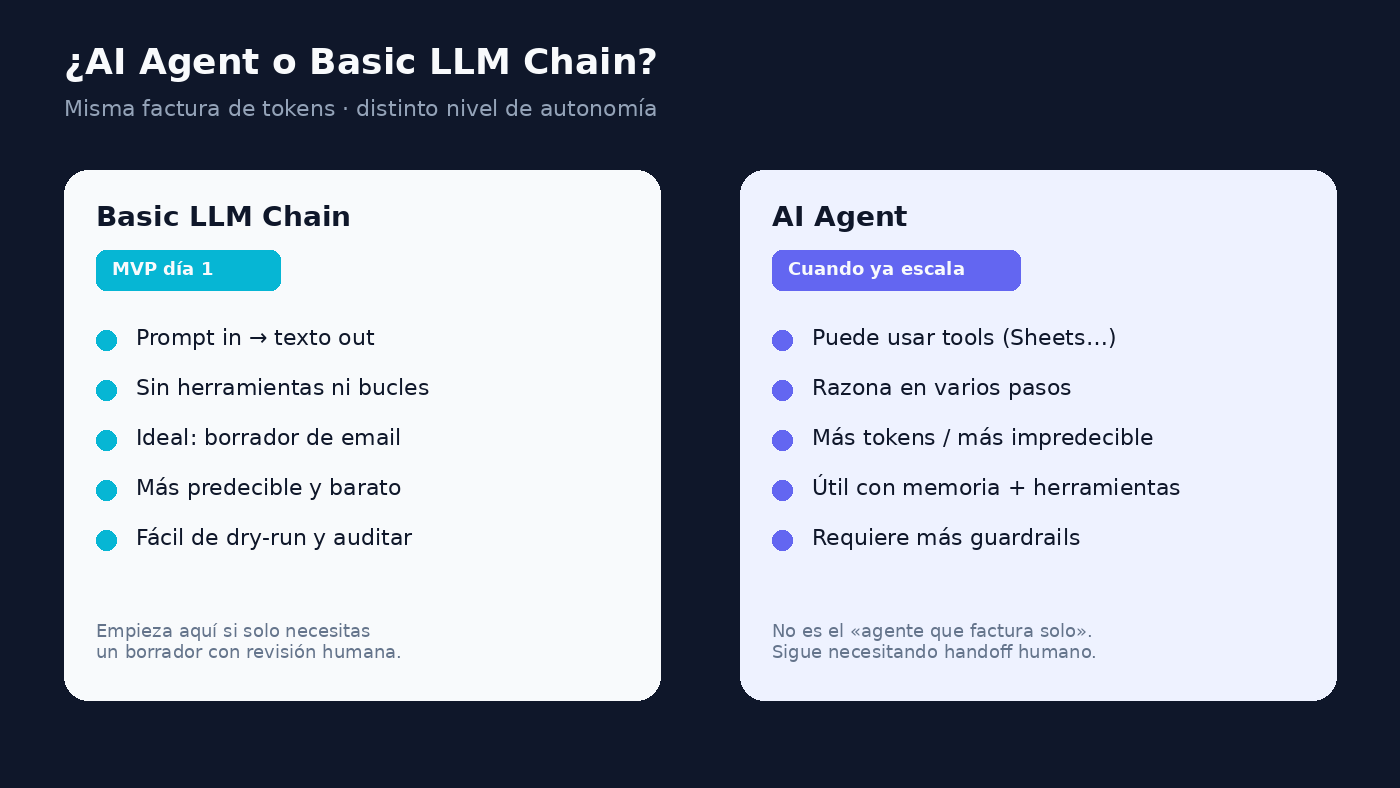
Regla DoAIWork: día 1 → Basic LLM Chain. Pasa a AI Agent cuando el borrador ya te ahorre tiempo y necesites que el nodo consulte una hoja o una tool concreta. No confundas los créditos del AI Assistant del plan Cloud (ayuda a construir/editar flujos en el editor) con el runtime del Agent (tokens que facturan OpenAI/Anthropic/etc. en cada ejecución). Son partidas distintas.
Nodo 4 — Handoff humano (no negociable)
Envía a Slack / Telegram / tu email:
- Resumen del lead.
- Borrador completo.
- Botones o respuesta clara:
OK/EDIT/NO.
Sin este nodo, no publicas el flujo. Un borrador mal enviado a las 23:40 cuesta más que 20 minutos de copy-paste.
Nodo 5 — Acción
Solo tras tu OK: enviar el email con Gmail/Outlook o marcar la fila en Sheets como «respondido». Si dijiste NO, archiva y etiqueta revisar-manual.
System prompt de ejemplo (estilo kit #5)
Cópialo en el nodo de IA. Sustituye corchetes. Anonimiza antes de pegar datos reales.
Eres el asistente de redacción de un autónomo en España.
Tono: cercano de «tú», profesional, sin postureo comercial.

CONTEXTO DEL LEAD (ya anonimizado):
"""
Nombre: [nombre]
Canal: [email / formulario]
Mensaje:
[pega solo el resumen limpio]
"""

DATOS QUE SÍ PUEDES USAR:
- Servicios: [lista breve]
- Precio orientativo: desde [XX] € (IVA aparte) — solo si está en esta lista
- Horario de respuesta: [L–V …]

TAREA: redacta un borrador de respuesta al lead.

FORMATO:
1) Asunto ≤8 palabras
2) Cuerpo 80–140 palabras
3) Un solo siguiente paso claro (call / email / más info)
4) Al final, una línea interna: CONFIANZA: alta|media|baja + motivo en 5 palabras

RESTRICCIONES:
- No inventes precios, plazos, disponibilidad ni descuentos.
- Si falta un dato, pídelo; no lo inventes.
- No uses urgencia falsa («solo hoy», «últimas plazas»).
- No pidas NIF, DNI ni datos bancarios.
- Si el mensaje parece reclamación, impago o tema legal: responde solo
  «Lo revisa una persona» y marca CONFIANZA: baja.
Misma lógica que en Prompts que funcionan (post #5): rol + contexto + tarea + formato + restricciones. La diferencia es que aquí el prompt vive dentro del flujo.
Dry-run y checklist de prueba
Antes de activar el workflow en producción:
- Credenciales: Gmail/Sheets/Slack conectados; API key del modelo en credenciales de n8n (nunca en capturas ni en el prompt visible).
- Email de prueba tuyo con etiqueta
Leadsy un mensaje inventado (sin datos reales de clientes). - Ejecuta una vez (manual o «Test workflow»).
- Comprueba: nodo 2 limpia bien; nodo 3 respeta restricciones; nodo 4 te llega el aviso; nodo 5 no envía hasta tu OK.
- Prueba el camino
NOy el de reclamación (debe devolver confianza baja). - Mira el contador de ejecuciones: 1 prueba = 1 ejecución en Cloud.
- Solo entonces: Active = on, con volumen real bajo la primera semana.
Checklist rápido
- Una sola fuente de trigger
- Datos sensibles fuera del LLM
- Handoff humano activo
- Sin envío automático el día 1
- Precios del prompt = tus precios reales
- RGPD: minimizas y no guardas logs eternos del cuerpo completo
Coste orientativo (28 sep 2026)
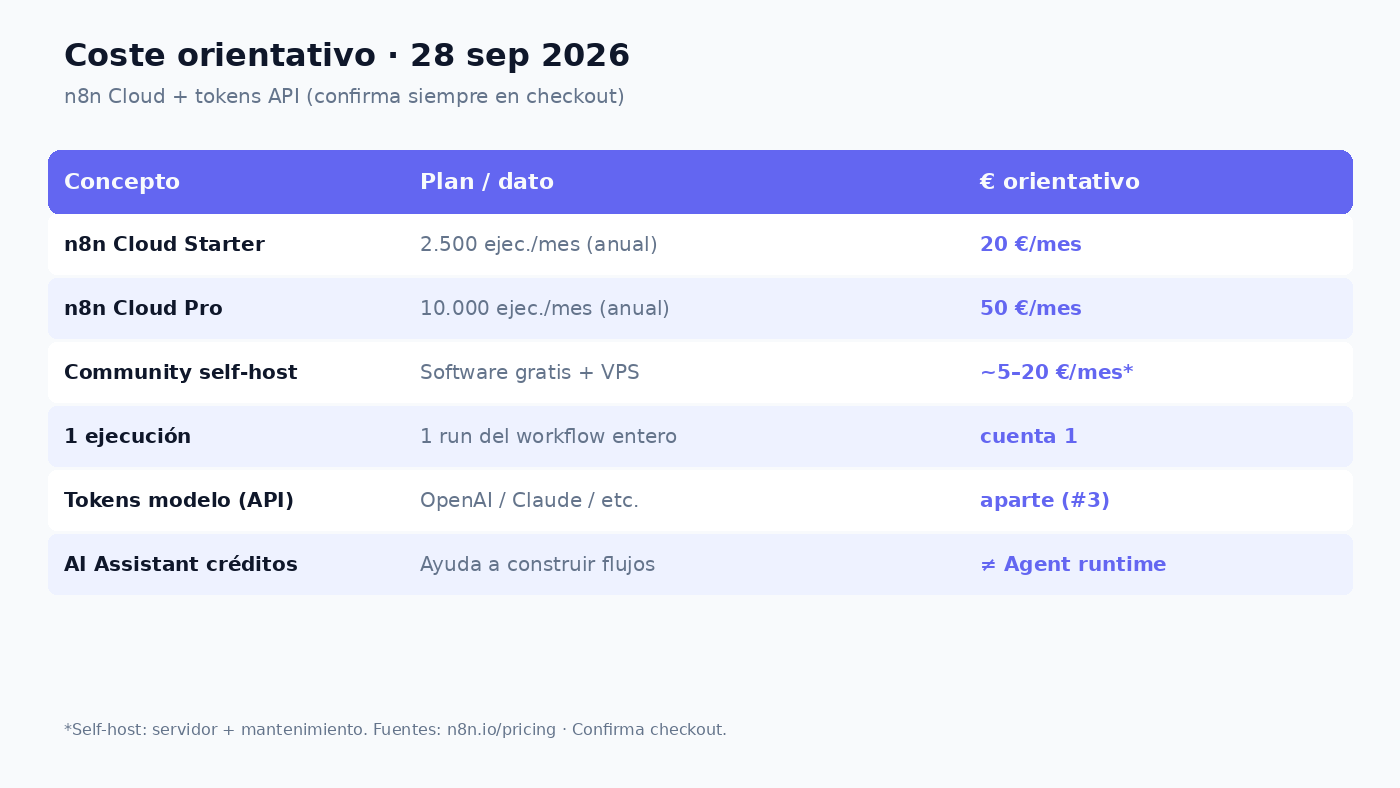
| Concepto | Dato | € orientativo |
|---|---|---|
| n8n Cloud Starter | 2.500 ejecuciones/mes | 20 €/mes (facturación anual) |
| n8n Cloud Pro | 25.000 ejecuciones/mes | 50 €/mes (anual) |
| Community self-host | Software gratis | Servidor ~5–20 €/mes + tu tiempo |
| 1 ejecución | 1 run del workflow completo | Da igual que tenga 5 o 25 nodos |
| Tokens del modelo | OpenAI / Claude / etc. | Aparte — ver post #3 |
| AI Assistant (créditos plan) | Ayuda en el editor | ≠ runtime del Agent |
Fuentes: n8n.io/pricing, integrations/agent. Mensual sin anual suele ser ~24 € Starter / ~60 € Pro; confirma en el checkout el día que contrates. IVA y tipo de cambio aparte.
Mini-ejemplo: 60 leads/mes × 1 ejecución ≈ 60 de 2.500 del Starter. El coste variable grande será el de tokens del modelo, no el de n8n, si el flujo es corto.
Errores típicos
- «Agente que responde y factura solo» — No. Sin handoff, un alucinación de precio o un tono seco te quema un lead.
- Meter WhatsApp API el día 1 — Otro producto, otro coste, otro compliance. Mención: siguiente paso → post #4.
- Confundir AI Assistant credits con Agent runtime — Los créditos del plan ayudan a construir; los tokens del modelo se pagan en cada run.
- Keys en capturas o en el system prompt visible — Credenciales solo en el vault de n8n.
- Trigger demasiado amplio — Acabas pagando ejecuciones por newsletters.
- Pasar datos personales crudos al LLM — Anonimiza; RGPD no es un disclaimer decorativo.
- Prometer precios de esta tabla como factura fija — Son orientativos; manda el checkout oficial.
Cuándo escalar a WhatsApp (#4)
Quédate en email/formulario + n8n mientras:
- El canal principal de leads sigue siendo email o web.
- Puedes revisar borradores en horario laboral.
- Aún no pierdes leads de forma sistemática por la noche.
Escala a WhatsApp (app bien configurada primero; API después) cuando el volumen o el fuera de horario lo justifiquen — detalle en el post #4. El flujo de este post es el puente: mismo handoff humano, otro canal.
CTA y fuentes
[CTA AFILIADO n8n] Prueba n8n Cloud Starter para este MVP. Enlace: [URL_AFILIADO_N8N]. DoAIWork puede recibir comisión sin coste extra para ti.
[CTA AFILIADO OpenAI] Si usas un modelo vía API para el nodo de IA: [URL_AFILIADO_OPENAI]. Elige modelo según post #3; el coste de tokens es aparte del plan n8n.
(Sustituir placeholders antes de publicar.)
Conclusión
Pasa el hábito de ChatGPT a un evento + borrador + revisión humana. Cinco nodos bastan. Basic LLM Chain el día 1; AI Agent cuando haga falta. Starter a ~20 €/mes suele sobrar para un autónomo que arranca; los tokens del modelo van aparte. Sin handoff, no hay «agente»: hay riesgo.
Fuentes (consulta 28 sep 2026):
- n8n Plans and Pricing
- n8n AI Agent integration
- DoAIWork: posts #2 Make vs n8n, #3 modelos, #4 WhatsApp, #5 prompts
Guías relacionadas
IA en WhatsApp Business: atender clientes sin contratar a nadie
WhatsApp Business con IA para autónomos: app vs API, 3 flujos copiables, costes orientativos ES 2026 y cuándo escalar.
Leer guía →Make vs n8n: qué automatizar primero si no tienes equipo IT
Make vs n8n sin equipo IT: tabla de costes, regla simple para elegir y 3 flujos de arranque para autónomos y pymes en España.
Leer guía →